Fonctionnement des moteurs de recherche : les 3 étapes qui décident de votre visibilité
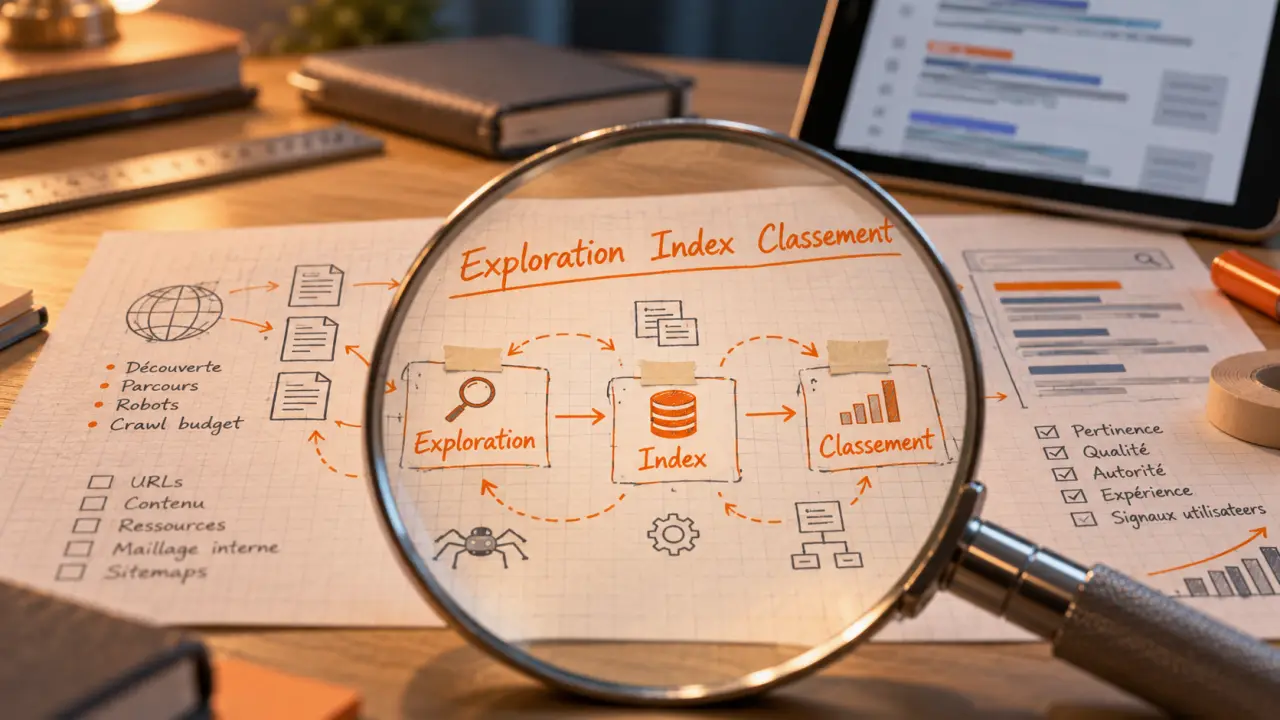
Lorsqu’un internaute saisit une requête, les résultats ne sont pas recherchés en direct sur l’ensemble du web. Le moteur sélectionne des pages dans un immense index déjà constitué, puis les ordonne selon leur pertinence supposée. Comprendre le fonctionnement des moteurs de recherche aide à mieux interpréter les résultats et à rendre un site plus accessible aux robots comme aux visiteurs.
Un moteur de recherche organise le web avant même votre requête
Un moteur de recherche aide à retrouver des informations en ligne à partir de mots, de questions ou d’images. Google, Bing, Qwant et DuckDuckGo n’analysent pas toutes les pages du web au moment précis où vous lancez une recherche. Ils s’appuient sur une base de données, appelée index, alimentée en continu par des programmes automatisés.
Le web ne possède pas de registre centralisé recensant toutes les pages publiées. Pour les découvrir, les moteurs utilisent des robots d’exploration, aussi appelés crawlers ou spiders. Googlebot, par exemple, suit les liens entre les pages et peut aussi prendre en compte les URL indiquées dans un sitemap. Son rôle n’est pas de comprendre un site comme un humain : il collecte, rend et analyse des signaux utilisables par les algorithmes.
Index, cache et page affichée : ne pas confondre
L’index est le catalogue interne du moteur. Il contient les informations analysées sur les pages jugées éligibles : sujet traité, langue, liens, éléments textuels, structure et autres signaux. Le cache désigne une version conservée d’une page à un instant donné. Il peut aider le moteur à traiter certains contenus, mais il ne remplace ni la page en ligne ni l’indexation.
Une page accessible dans un navigateur n’est donc pas automatiquement présente dans l’index. À l’inverse, une page indexée n’est pas forcément visible pour une requête précise. Elle doit encore être considérée comme suffisamment pertinente face aux autres résultats disponibles.
Les 3 étapes du fonctionnement des moteurs de recherche
Le cycle paraît linéaire, mais il se répète sans cesse. Les sites évoluent, de nouvelles URL apparaissent et certains contenus deviennent obsolètes. Les trois phases suivantes décrivent l’essentiel du processus.
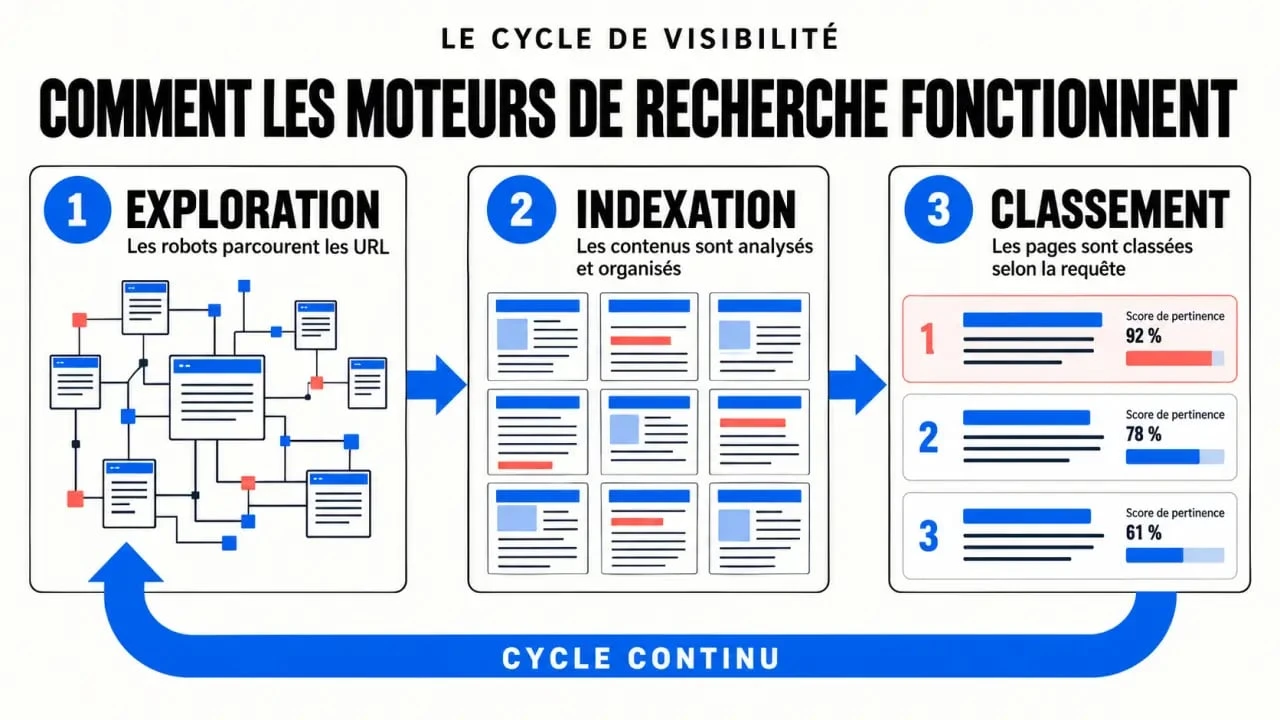
| Étape | Objectif du moteur | Ce qu’un site doit faciliter |
|---|---|---|
| Exploration | Découvrir et consulter les URL | Liens internes, sitemap, pages accessibles |
| Indexation | Analyser et enregistrer les contenus utiles | Contenu original, balisage clair, URL canonique |
| Classement | Ordonner les résultats pour une requête | Réponse pertinente, expérience fluide, crédibilité |
L’exploration : les robots trouvent les chemins d’accès
Le crawling commence souvent par un lien déjà connu. Le robot suit les liens hypertexte, découvre de nouvelles URL et revient régulièrement vérifier les pages existantes. Un sitemap XML peut lui signaler les pages importantes, mais il ne garantit ni leur exploration ni leur indexation.
Les obstacles sont nombreux : liens cassés, redirections en chaîne, pages bloquées par le fichier robots.txt, erreurs serveur ou navigation inaccessible. Sur les sites volumineux, le crawl budget correspond aux ressources que le moteur est susceptible de consacrer à l’exploration. Il devient alors utile de ne pas mobiliser cette capacité sur des URL inutiles, dupliquées ou générées sans valeur.
L’indexation : le moteur interprète ce qu’il a trouvé
Après avoir récupéré une page, le moteur analyse son contenu et peut exécuter le JavaScript nécessaire au rendu. Il étudie notamment le texte visible, la balise title, les titres, les liens, les images et leur attribut alt. Il cherche aussi à identifier les doublons pour retenir une URL canonique, c’est-à-dire la version de référence d’un contenu très proche.
L’indexation reste une décision du moteur. Une page pauvre, presque identique à d’autres, protégée par une directive d’exclusion ou difficile à rendre peut ne pas être retenue. Publier une page ne suffit donc pas : elle doit être techniquement accessible et apporter une information clairement identifiable.
Le classement : une réponse est choisie parmi les pages indexées
À chaque requête, l’algorithme compare les pages disponibles dans l’index. Il ne cherche pas uniquement une répétition exacte des mots saisis. Il tente aussi d’interpréter l’intention, la langue, le contexte géographique, l’appareil utilisé et la fraîcheur éventuelle de l’information. Les résultats affichés dans la SERP peuvent ainsi différer d’un utilisateur à l’autre.
Pourquoi certaines pages arrivent avant d’autres
Le classement repose sur des centaines de facteurs et sur leurs combinaisons. Aucun réglage isolé ne propulse durablement une page. La priorité reste sa capacité à répondre clairement et de manière fiable à ce que l’internaute cherche.
Pertinence, qualité et popularité forment un ensemble
Un contenu pertinent traite précisément le sujet attendu, avec un vocabulaire adapté et une structure facile à parcourir. La balise title aide à annoncer le thème de la page, tandis que des titres hiérarchisés organisent les informations. La qualité perçue dépend aussi de la profondeur, de l’originalité et de l’absence de promesses trompeuses.
Les liens entrants, souvent appelés backlinks, peuvent transmettre des signaux de popularité et de confiance lorsqu’ils proviennent de pages pertinentes. Leur valeur ne se réduit pas à leur quantité. Un lien cohérent, placé dans un contenu utile, a davantage de sens qu’une accumulation artificielle de liens sans rapport avec le sujet.
Un site fonctionne comme un mécanisme dans lequel chaque élément transmet une information au suivant. Une page importante doit être reliée depuis la navigation, décrite par une ancre compréhensible, chargée correctement, puis soutenue par un contenu qui tient sa promesse. Si un maillon se grippe, par exemple une catégorie inaccessible, une redirection inutile ou une page orpheline, la valeur produite plus loin peut ne jamais parvenir au moteur. Le maillage interne sert donc à la fois à guider les visiteurs et à indiquer la hiérarchie du site aux robots.
L’expérience de consultation compte aussi
Un temps de chargement raisonnable, une page lisible sur mobile, des URL stables et une navigation simple facilitent la consultation. Ces éléments ne remplacent pas un contenu utile, mais ils réduisent les frictions rencontrées par les visiteurs et les robots. Une page qui répond au besoin sans pouvoir s’afficher ou se parcourir correctement perd une partie de son potentiel de visibilité.
Les actions concrètes pour favoriser exploration et indexation
Le SEO technique vise moins à convaincre un robot qu’à lui éviter les ambiguïtés. Les bonnes pratiques suivantes servent aussi aux internautes, car elles rendent le site plus cohérent et plus facile à parcourir.
- Construire un maillage interne pertinent : relier les pages importantes depuis des pages déjà accessibles, avec des ancres descriptives.
- Maintenir un sitemap à jour : y inclure les URL canoniques réellement utiles, sans ajouter de pages supprimées ou bloquées.
- Traiter les erreurs et les redirections : corriger les liens cassés et limiter les parcours inutiles avant d’atteindre une page.
- Éviter le contenu dupliqué : différencier les pages proches et déclarer une URL canonique lorsque c’est nécessaire.
- Vérifier le rendu des pages : un contenu chargé uniquement via JavaScript doit rester correctement interprétable par les robots.
- Surveiller l’indexation : des outils comme Search Console permettent d’identifier des problèmes d’exploration, de couverture ou de compatibilité.
Les idées reçues qui nuisent à la compréhension du SEO
La première confusion consiste à croire que soumettre une URL assure sa présence dans les résultats. Une soumission ou un sitemap peut faciliter la découverte, mais le moteur garde la main sur l’exploration, l’indexation et le classement. Il faut donc examiner la qualité de la page avant de chercher un raccourci.
Autre mythe fréquent : remplir des balises meta keywords améliorerait le positionnement. Cette balise ne constitue pas une solution de visibilité. À l’inverse, le title, le contenu visible, le maillage interne et la qualité technique aident réellement le moteur à comprendre la page.
Enfin, le référencement payant, ou SEA, n’améliore pas mécaniquement le classement naturel. Les annonces et les résultats organiques répondent à des logiques distinctes. Acheter de la visibilité peut compléter une stratégie commerciale, mais ne remplace ni l’indexation ni un contenu solide. Les pratiques de cloaking, qui présentent un contenu différent aux robots et aux internautes, sont également à éviter : elles créent une rupture de confiance et peuvent dégrader la visibilité.

- Fonctionnement des moteurs de recherche : les 3 étapes qui décident de votre visibilité - 30 septembre 2026
- Digital RH : automatiser les processus sans déshumaniser la fonction RH - 29 septembre 2026
- Un cabinet de recrutement marketing digital pour cibuer les bons profils sans négliger l’évaluation - 28 septembre 2026
Articles qui pourraient vous intéresser :
 Community management : automatisez votre création de contenu et votre veille sans sacrifier l’engagement
 Réseaux sociaux : 5,2 milliards d’utilisateurs et comment choisir votre plateforme
 Merchandising : 3 leviers pour transformer vos visiteurs en acheteurs
 Earned media : gagner en visibilité sans acheter d’espace publicitaire